8. Deadlock
Un insieme di processi è in deadlock quando ogni processo è in attesa di un evento che può essere causato solo da un processo dello stesso insieme, dunque a sua volta in attesa. Vediamo ora le
Condizioni necessarie per l'avvenimento di un deadlock
- Mutua esclusione: almeno una delle risorse deve essere non condivisibile. Per esempio, un processo richiede una risorsa ma questa è già utilizzata da un altro processo, quindi deve aspettare che si liberi.
- Hold and Wait: deve esserci almeno un processo nel gruppo che detiene una risorsa, ma è bloccato, in quanto necessita di almeno un'altra risorsa, detenuta da un altro processo.
- No pre-emption: le risorse possono essere rilasciate solo dopo il loro utilizzo, la possessione di una risorsa non può essere rescissa forzatamente.
- Attesa circolare: devono esistere
processi in attesa del rilascio delle risorse tali che attenda , attenda attenda .
Vediamo ora un modo per visualizzare graficamente l'eventuale avvenimento di deadlock.
Modello Astratto (RAG)
Un Resource Allocation Graph (in breve RAG) è un modello astratto per la determinazione e la rappresentazione di eventuali situazioni di deadlock. Nello specifico, il RAG è un grafo
indica il numero di nodi: cerchi per indicare i processi e rettangoli per indicare le risorse; all'interno dei rettangoli verranno indicate con dei pallini il numero di istanze corrispondenti a tale risorsa. indica il numero di archi: dal processo (cerchio) alla risorsa (rettangolo) significa che il processo richiede tale risorsa; dalla risorsa al processo indica che tale risorsa è detenuta da quel processo. Gli archi possono essere orientati e vengono indicati con una freccia.
Esempio 1

In questo esempio
Come capiamo se si verificherà un deadlock?
Se il RAG non contiene cicli, non sono presenti deadlock. Se presenta cicli, possiamo distinguere due casi:
- La risorsa ha una sola istanza, pertanto si avrà una situazione di deadlock.
- Ci sono più istanze, allora la determinazione del deadlock dipende dallo schema di allocazione.
Esempio 2

Esaminano ora le principali soluzioni per la prevenzione, rilevazione e correzione dei deadlock.
Deadlock Prevention (prevenzione statica)
L'obiettivo è impedire che si verifichi una delle
Analizziamo quindi una ad una le
Mutua esclusione
È impossbile impedire totalmente la mutua esclusione per alcuni tipi di risorse
Hold and wait
Soluzioni
- Un processo alloca all’inizio tutte le risorse che deve utilizzare
- Un processo può ottenere una risorsa solo se non ne ha altre
Problemi
- Diminuisce di molto utilizzo delle risorse
- Aumenta il rischio di starvation per i processi che necessitano di risorse molto richieste, rischiando che debbano aspettare potenzialmente all'infinito
No pre-emption
Soluzioni
- Si può imporre che un processo in waiting che richiede una risorsa non disponibile rilasci tutte le risorse in suo possesso.
- Cedere le sue risorse ad un altro processo, se saranno sufficienti a farlo eseguire.
Problemi
- Applicabile solo per risorse particolari il cui stato può essere salvato e ripristinato facilmente, come CPU o memoria, e non per stampanti, nastri ecc.
Attesa circolare
Soluzioni
- Si stabilisce un valore di priorità per ogni risorsa e si impone che un processo possa effettuare richieste in serie solo con priorità crescente.
Problemi
- Il problema sta nello stabilire la priorità, in quanto questo dovrebbe rispettare l'ordine delle richieste.
Svantaggi
In generale queste soluzioni sono molto costose e possono degradare notevolmente le prestazioni.
Deadlock Avoidance (prevenzione dinamica)
La prevenzione statica ha lo svantaggio di diminuire l'utilizzo delle risorse quindi il throughput del sistema. Gli algoritmi di prevenzione dinamica tendono a migliorare le prestazioni, ma necessitano delle informazioni sulle richieste che ogni processo potrebbe fare.
Nello specifico, per ogni processo è necessario sapere:
- il numero massimo di istanze di ogni risorsa che esso potrebbe richiedere
- le eventuali risorse disponibili o già allocate
Questi algoritmi si basano sul mantenere uno stato safe del sistema. Questo avviene se esiste una sequenza safe, ovvero, se usando le risorse disponibili, il sistema può allocare risorse ad ogni processo, in qualche ordine, in modo che ciascun di essi possa terminare la sua esecuzione.
Più precisamente, una sequenza di processi
Dunque riassumendo, l'idea è utilizzare algoritmi che lasciano il sistema sempre in uno stato safe. All’inizio il sistema è in uno stato safe. Ogni volta che
Svantaggi
L’utilizzo delle risorse è minore rispetto al caso in cui non uso tecniche di prevenzione dinamica.
Tra gli algoritmi che si basano sul mantenere uno stato safe abbiamo due principali alternative:
- Algoritmo con RAG
- Funziona solo se c’è una sola istanza per risorsa
- Algoritmo del banchiere
- Funziona qualunque sia il numero di istanze
Vediamoli ora nel dettaglio.
Algoritmo Resource Allocation Graph (RAG)
Funziona solo con un'unica istanza per risorsa. Si rappresentano processi e risorse come nodi di un grafo orientato. Gli archi assumono significati diversi a seconda del tipo:
Esempio
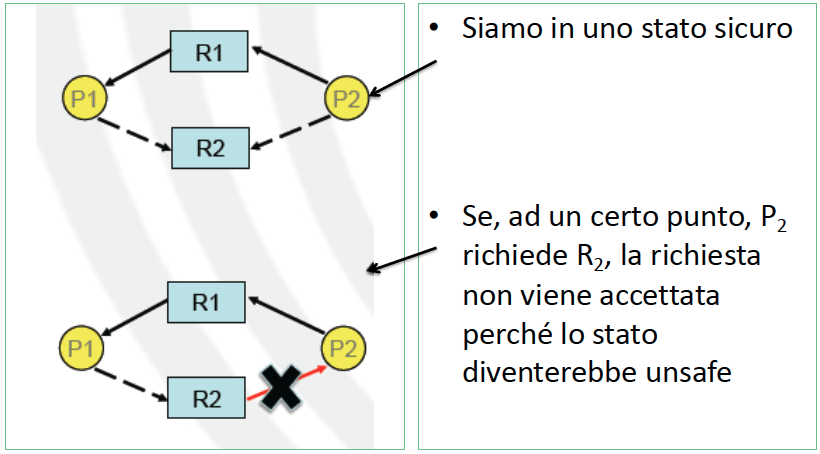
Algoritmo del banchiere
Come il RAG, ha bisogno di sapere il numero massimo di istanze che ogni processo potrebbe richiedere per ogni risorsa, ma funziona con qualsiasi numero di istanze, anche se è meno efficiente del RAG. Si basa sul mantenere delle strutture dati (matrici) con le informazioni sulle risorse richieste e allocate da ogni processo e sulle risorse di sistema disponibili. Ad ogni richiesta, si stabilisce se questa è possibile da soddisfare restando in uno stato safe, simulando l'assegnazione delle risorse. È costituito dunque da due algoritmi, l'algoritmo di allocazione e l'algoritmo di verifica dello stato.
Vediamo ora quali strutture dati vengono utilizzate:
int n; //i processi disponibili
int available[m]; // numero di istanze di R_i disponibili
int max[n][m]; // matrice delle richieste di risorse, le righe rappresentano i processi
			   // le colonne le risorse
int alloc[n][m]; // matrice di allocazione corrente
int need[n][m]; // matrice bisogno rimanente, ovvero need[i][j] = max[i][j]-alloc[i][j]
Vediamo ora una possibile implementazione dell'algoritmo di allocazione.
// request_vector è un vettore contenente le richieste del processo P_i
// ossia la colonna di max[i] dove i è il processo P_i
void request (int req_vec []) {
//se almeno un elemento è maggiore lancia un errore
	if (req_vec [] > need[i][])
		error(); //il processo vuole usare di più del massimo dichiarato
	if (req_vec[] > available[])
		wait(); //se non ci sono abbastanza risorse per soddisfare il processo, aspetto

// simuliamo l'allocazione
available[] = available[] - req_vec[]; //risorse disponibili -= risorse richieste
alloc[i][] = alloc[] + req_vec[]; //risorse allocate += risorse richieste
need[i][] = need[i][] - req_vec[]; //risorse di cui necessito -= risorse richieste

if(!state_safe()) { /* se non è safe, ripristino il vecchio stato */
	//rollback
	available[] = available[] + req_vec[];
	alloc[i][] = alloc[] - req_vec[];
	need[i][] = need[i][] + req_vec[];
	wait();
}
Vediamo ora una possibile implementazione dell'algoritmo di verifica dello stato.
//ritorno true se lo stato è safe, false se non è safe
//Complessità: O(m*n^2)
boolean state_safe() {
	//vettore locale uguale ad available[]
	int work[m] = available[];
	boolean finish[n] = (FALSE, ..., FALSE);
	int i;
	while(finish != (TRUE, ..., TRUE)) {
		/* cerca P_i che NON abbia terminato e che possa completare con le risorse disponibili in work. L'ordine non ha importanza. Se più processi possono eseguire, ne posso scegliere uno a caso, gli altri eseguiranno dopo, visto che le risorse possono solo aumentare. */
		/* Nello specifico, per ogni processo si controlla se ci sono abbastanza risorse disponibili per soddisfarlo. Se è così, si esce dal for e lo si soddisfa. Se non riesco a soddisfare tutti i processi ritornerò false. */
		for(i = 0; (i < n) && (finish[i] || need[i][] > work[]); i++);
		if(i == n)
			return FALSE; /* non ho trovato una sequenza safe */
		else {
			work[] = work[] + alloc[i][];
			finish[i] = TRUE;
		}
	}
	return TRUE;
}
Il problema principale dell'algoritmo del banchiere è la sua inefficienza, il semplice controllo dello stato safe/unsafe ha costo
Esempio
Vediamo ora un esempio sul funzionamente dell'algoritmo del banchiere.
Abbiamo
- A (
istanze) - B (
istanze) - C (
istanze)
Inoltre, questa è la situazione al tempo
Questa è la tabella dell'allocazione delle risorse, ossia nell'istante
| Allocation | A | B | C |
|---|---|---|---|
Questa è la tabella delle risorse totali che ogni processo necessita di usare.
| Max | A | B | C |
|---|---|---|---|
Calcoliamo ora quante istanze delle risorse A, B, C sono ancora disponibili al tempo
Vediamo A:
| A | |
|---|---|
| Istanze totali di A usate: | |
| Istanze di A ancora usabili : |
Vediamo B:
| B | |
|---|---|
| Istanze totali di B usate: | |
| Istanze di B ancora usabili : |
Vediamo C:
| C | |
|---|---|
| Istanze totali di C usate: | |
| Istanze di C ancora usabili : |
Dunque al tempo
| Available | A | B | C |
|---|---|---|---|
Infine, calcoliamo quante risorse ogni processo necessita ancora, facendo MAX[] - ALLOCATION[], ossia risorse totali di cui necessito - risorse che sono già riuscito ad allocare.
| Need | A | B | C |
|---|---|---|---|
Detto questo, diamo per vero che al tempo
Ipotizziamo ora che
Verifichiamo prima di tutto se
Dunque
| Allocation | A | B | C |
|---|---|---|---|
| Available | A | B | C |
|---|---|---|---|
| Need | A | B | C |
|---|---|---|---|
Non ci resta che eseguire l'algoritmo (la funzione request() sopra) e verificare se si presenterà un deadlock.
Abbiamo innanzitutto che work[] = {2,3,0}.
Ora parte il for(), che per ogni processo controlla se ci sono abbastanza risorse disponibili per soddisfarlo.
i=0 finish=FALSE, need[0] = (7,4,3) > work ❌
Dunque
i=1 finish=FALSE, need[1] = (0,2,0) <= work ✅
Quindi
Quindi si fa partire per primo
work = work + (3,0,2) = (5,3,2)
finish[1] = TRUE
A questo punto il for riinizia dall'inizio e ripassa tutti i processi.
i=0 finish=FALSE, need[0]=(7,4,3) > work ❌
i=1 finish=TRUE
i=2 finish=FALSE, need[2]=(6,0,0) > work ❌
i=3 finish=FALSE, need[3]=(0,1,1) <= work ✅
Quindi
work = work + (2,1,1) = (7,4,3)
finish[3] = TRUE
A questo punto il for riinizia dall'inizio e ripassa tutti i processi.
i=0 finish=FALSE, need[0]=(7,4,3) <= work ✅
Quindi
work = work + (0,1,0) = (7,5,3)
finish[0] = TRUE
A questo punto il for riinizia dall'inizio e ripassa tutti i processi.
i=0 finish=TRUE
i=1 finish=TRUE
i=2 finish=FALSE, need[2]=(6,0,0) <= work ✅
Quindi
work = work + (3,0,2) = (10,5,5)
finish[2] = TRUE
A questo punto il for riinizia dall'inizio e ripassa tutti i processi.
i=0 finish=TRUE
i=1 finish=TRUE
i=2 finish=TRUE
i=3 finish=TRUE
i=4 finish=FALSE, need[4]=(4,3,1) <= work ✅
Quindi
work = work + (0,0,2) = (10,5,7)
finish[4] = TRUE
Tutti i processi sono riusciti a prendere le risorse di cui necessitavano e la sequenza safe trovata è <
Ipotizziamo ora che
Verifichiamo prima di tutto se
Dunque
| Allocation | A | B | C |
|---|---|---|---|
| Available | A | B | C |
|---|---|---|---|
| Need | A | B | C |
|---|---|---|---|
Non ci resta che eseguire l'algoritmo (la funzione request() sopra) e verificare se si presenterà un deadlock.
Abbiamo innanzitutto che work[] = {2,1,0}.
Ora parte il for(), che per ogni processo controlla se ci sono abbastanza risorse disponibili per soddisfarlo.
i=0 finish=FALSE, need[0] = (7,2,3) > work ❌
i=1 finish=FALSE, need[1] = (0,2,0) > work ❌
i=2 finish=FALSE, need[2] = (6,0,0) > work ❌
i=3 finish=FALSE, need[3] = (0,1,1) > work ❌
i=4 finish=FALSE, need[4] = (4,3,1) > work ❌
Quindi nessun processo riuscirebbe più ad allocare risorse, siamo in uno stato unsafe!
Deadlock Detection and Recovery (algoritmi di rilevamento del deadlock e di ripristino)
Entrambi i metodi di prevenzione visti sopra tendono a ridurre la disponibilità delle risorse per la prevenzione di un problema che si presenta raramente. Si può optare invece per degli algoritmi di rilevamento del deadlock e di ripristino, che sebbene siano svantaggiati dal costo di ripristino, non richiedono conoscenze a priori sulle risorse e le richieste.
Di seguito due algoritmi di rilevamento, ciascuno derivato da uno degli algoritmi di avoidance.
Rilevazione e ripristino con RAG (Algoritmo Wait-for)
Basato sul RAG, funziona solo con un'unica istanza per risorsa. Viene mantenuto in memoria un grafo d'attesa (da qui il nome wait-for), cioè una struttura dati creata appositamente per questa funzione, ottenuta eliminando i nodi risorsa dal RAG e collassando i vertici. Nel grafo così ottenuto un arco
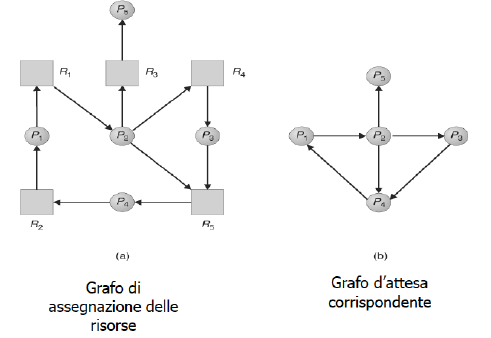
Quindi i vantaggi sono che la conoscenza anticipata delle richieste non è più necessaria e le risorse non vengono sprecate per prevenire un deadlock. Ovviamente lo svantaggio è il costo del recovery.
Algoritmo di rilevamento del banchiere
Utilizza una struttura dati molto simile all'omonimo algoritmo di deadlock avoidance, funziona quindi con qualsiasi numero di istanze. Si basa sul verificare in tempo
Vediamo ora quali strutture dati vengono utilizzate:
int n; //i processi disponibili
int available[m]; // numero di istanze di R_i disponibili
int alloc[n][m]; // matrice di allocazione corrente
int need[n][m]; // matrice delle richieste che devono ancora essere soddisfatte
Vediamo ora una possibile implementazione dell'algoritmo.
//ritorno true se lo stato è safe, false se non è safe
//Complessità: O(m*n^2)
boolean state_safe() {
	int work[m] = available[m];
	bool finish[] = (FALSE,...,FALSE);
	bool found = TRUE; //per vedere se faccio un for intero senza mai trovare un processo che può eseguire
	while (found) {
		found = FALSE;
		for (i=0; i<n && !found; i++) {
			/* cerca un Pi con richiesta soddisfacibile */
			if (!finish[i] && need[i][] <= work[]){
				/* assume ottimisticamente che Pi esegua fino al termine
				e che quindi restituisca le risorse. Se non è così,
				il possibile deadlock verrà evidenziato alla prossima
				esecuzione dell'algoritmo. */
				work[] = work[] + alloc[i][];
				finish[i]=TRUE;
				found=TRUE;
			}
		}
	} /* se finish[i]=FALSE per un qualsiasi i, Pi è in deadlock */
}
Sì, è letteralmente identico a state_safe() dell'algoritmo del banchiere in prevenzione dinamica, solo che si usa la variabile found al posto di if(i == n) e il for non riparte ogni volta ma va avanti. La vera differenza però è che quell'algoritmo, per ogni richiesta di risorsa da parte di un processo, prova ad effettuare l'allocazione e in caso di deadlock la annulla. Qui le allocazioni non hanno un controllo, ma semplicemente ogni tanto si fa partire la funzione state_safe() e se c'è un deadlock si fa un ripristino.
Esempio
Vediamo ora un esempio sul funzionamento di questo algoritmo.
Abbiamo
- A (
istanze) - B (
istanze) - C (
istanze)
Inoltre, questa è la situazione al tempo
Questa è la tabella dell'allocazione delle risorse, ossia nell'istante
| Allocation | A | B | C |
|---|---|---|---|
Questa è la tabella delle risorse che ogni processo necessita ancora.
| Need | A | B | C |
|---|---|---|---|
Calcoliamo ora quante istanze delle risorse A, B, C sono ancora disponibili al tempo
Vediamo A:
| A | |
|---|---|
| Istanze totali di A usate: | |
| Istanze di A ancora usabili : |
Vediamo B:
| B | |
|---|---|
| Istanze totali di B usate: | |
| Istanze di B ancora usabili : |
Vediamo C:
| C | |
|---|---|
| Istanze totali di C usate: | |
| Istanze di C ancora usabili : |
Dunque al tempo
| Available | A | B | C |
|---|---|---|---|
Orco! Non ci sono risorse disponibili, ma questo non vuol dire che sia un deadlock!
Detto questo, non ci resta che eseguire l'algoritmo (la funzione state_safe() sopra) e verificare se siamo in una situazione di deadlock.
Abbiamo innanzitutto che work[] = {0,0,0}.
Ora parte il for(), che per ogni processo controlla se ci sono abbastanza risorse disponibili per soddisfarlo.
i=0 finish=FALSE, need[0] = (0,0,0) <= work ✅
Quindi
work = work + (0,1,0) = (0,1,0)
finish[0] = TRUE
A questo punto il for continua.
i=1 finish=FALSE, need[1]=(2,0,2) > work ❌
i=2 finish=FALSE, need[2] = (0,0,0) <= work ✅
Quindi
work = work + (3,0,3) = (3,1,3)
finish[2] = TRUE
A questo punto il for continua.
i=3 finish=FALSE, need[3]=(1,0,0) <= work ✅
Quindi
work = work + (2,1,1) = (5,2,4)
finish[3] = TRUE
A questo punto il for continua.
i=4 finish=FALSE, need[4]=(0,0,2) <= work ✅
Quindi
work = work + (0,0,2) = (5,2,6)
finish[4] = TRUE
A questo punto il for è finito ma siccome almeno un processo è riuscito ad allocare le risorse, found è stato impostato a true e il for riparte dall'inizio.
i=0 finish=TRUE
i=1 finish=FALSE, need[1]=(2,0,2) <= work ✅
Quindi
work = work + (2,0,0) = (7,2,6)
finish[1] = TRUE
A questo punto il for continua.
i=2 finish=TRUE
i=3 finish=TRUE
i=4 finish=TRUE
A questo punto il for è finito ma siccome almeno un processo è riuscito ad allocare le risorse, found è stato impostato a true e il for riparte dall'inizio.
i=0 finish=TRUE
i=1 finish=TRUE
i=2 finish=TRUE
i=3 finish=TRUE
i=4 finish=TRUE
Il for è terminato nuovamente, nessuno ha allocato risorse quindi found è rimasto a false. Dunque si esce dal while e si verifica se
La risposta è si, tutti i processi sono riusciti a prendere le risorse di cui necessitavano e la sequenza safe trovata è <
Vediamo ora un esempio in cui lo stato non è safe e bisogna ripristinare tutto.
Supponiamo che
| Need | A | B | C |
|---|---|---|---|
Non ci resta quindi che eseguire l'algoritmo (la funzione state_safe() sopra) e verificare se siamo in una situazione di deadlock.
Abbiamo innanzitutto che work[] = {0,0,0}.
Ora parte il for(), che per ogni processo controlla se ci sono abbastanza risorse disponibili per soddisfarlo.
i=0 finish=FALSE, need[0] = (0,0,0) <= work ✅
Quindi
work = work + (0,1,0) = (0,1,0)
finish[0] = TRUE
A questo punto il for continua.
i=1 finish=FALSE, need[1]=(2,0,2) > work ❌
i=2 finish=FALSE, need[2]=(0,0,1) > work ❌
i=3 finish=FALSE, need[3]=(1,0,0) > work ❌
i=4 finish=FALSE, need[4]=(0,0,2) > work ❌
A questo punto il for è finito ma siccome almeno un processo è riuscito ad allocare le risorse, found è stato impostato a true e il for riparte dall'inizio.
i=0 finish=TRUE
i=1 finish=FALSE, need[1]=(2,0,2) > work ❌
i=2 finish=FALSE, need[2]=(0,0,1) > work ❌
i=3 finish=FALSE, need[3]=(1,0,0) > work ❌
i=4 finish=FALSE, need[4]=(0,0,2) > work ❌
Il for è terminato nuovamente, nessuno ha allocato risorse quindi found è rimasto a false. Dunque si esce dal while e si verifica se
La risposta è no,
Dunque, abbiamo detto prima che "ogni tanto" si fa partire l'algoritmo visto sopra. Ma a quanto corrisponde quel "ogni tanto"?
La frequenza di invocazione di un algoritmo di rilevamento dipende dalla frequenza con cui si verificano deadlock nel sistema. Generalmente vengono invocati ogni
Detto questo, come ripristiamo il sistema ad uno stato safe?
Generalmente si opta per la gestione automatica da parte del sistema, che può intervenire in due modi: uccidendo tutti processi coinvolti o riprendendosi le risorse contese. Nel primo caso, l'uccisione di tutti i processi, si ha un elevato costo per il sistema e, nel caso i processi stessero interagendo con periferiche, si rischiano incosistenze. Inoltre tutti i processi dovrebbero ripartire, perdendo così il lavoro svolto. Spesso quindi si sceglie un'uccisione selettiva, ma in tal caso è necessaria una qualche politica per stabilire un ordine di priorità per la sequenza di uccisione. Inoltre, dopo ogni uccisione, è necessario invocare nuovamente l'algoritmo di rilevamento per stabilire se c'è ancora un deadlock. Se si sceglie la prelazione delle risorse, si deve anche in questo caso definire una politica per stabilire a chi vengono tolte le risorse ed in quale ordine. Nella situazione peggiore si deve effettuare un total rollback (cioè riparto da zero!). Segue che le operazioni di rollback, ovvero di ripristino ad uno stato passato per un processo, sono particolarmente costose ed esiste la possibilità di starvation.
Conclusioni
Abbiamo capito che ognuno dei 4 approcci visti ha vantaggi e svantaggi. Dunque, come sempre si è soliti fare in queste situazioni, si può cercare una soluzione combinata. Si può quindi suddividere le risorse in classi (tipo risorse interne, memoria, risorse di processo e spazio di swap) e per ognuna di esse scegliere l'algoritmo più appropriato.
C'è anche una soluzione molto più semplice, usata per esempio in UNIX, ossia il complesso algoritmo dello struzzo. Semplicemente si nasconde la testa sotto la sabbia e si fa finta che i deadlock non si possano mai verificare.