12. File System
Il file system fornisce il meccanismo per la memorizzazione e l’accesso di dati e programmi. Consiste di una collezione di file e della struttura di cartelle (directory).
Interfaccia del file system
Concetto di file
Il sistema operativo astrae dalle caratteristiche fisiche dei supporti di memorizzazione fornendo una loro visione logica. Si considera un file come uno spazio di indirizzamento logico e contiguo rappresentante un insieme di informazioni correlate identificate da un nome. I file possono essere dati di qualsiasi tipo e programmi.
Attributi di un file
Su disco, nella struttura della directory, sono salvati per ogni file il nome (unica informazione in formato leggibile), tipo, posizione (puntatore allo spazio fisico sul dispositivo), dimensione, protezione (controllo sui permessi), tempo, data e identificazione dell’utente.
Operazioni sui file
- Creazione: si cerca lo spazio necessario su disco e si crea un nuovo elemento sulla directory per gli attributi.
- Scrittura: una system call che specifica il nome del file e i dati da scrivere, è necessario che sia noto il puntatore alla locazione della prossima scrittura.
- Lettura: una system call che specifica il nome del file e dove mettere i dati letti in memoria, è necessario conoscere il puntatore alla locazione della prossima lettura, lo stesso della scrittura.
- Riposizionamento all’interno di file: aggiornamento del puntatore alla posizione corrente.
- Cancellazione: libera lo spazio associato al file e l’elemento corrispondente nella directory.
- Troncamento: mantiene inalterati gli attributi ma cancella il contenuto del file.
- Apertura: ricerca il file nella struttura della directory su disco, copia il file in memoria e inserisce un riferimento nella tabella dei file aperti. In sistemi multi-utente si trovano 2 tabelle: una per ogni processo che contiene i riferimenti per i file aperti relativi a esso e una per tutti i file aperti da tutti i processi che contiene i dati indipendenti dal processo.
- Chiusura: copia del file in memoria su disco.
Struttura dei file
I tipi di file possono essere usati per indicare la struttura interna del file. Di seguito 3 esempi di struttura di file.
- Nessuna struttura: si considera un file come una sequenza di parole o bytes, come avviene ad esempio in Unix.
- Struttura a record semplice: un record è una riga di lunghezza fissa o variabile.
- Struttura complessa: come accade nei documenti formattati e i formati ricaricabili (load module).
Le ultime due si possono emulare con la prima usando caratteri di controllo.
Metodi di accesso
Sequenziale
Questo metodo viene usato da editor e compilatori, permettono le operazioni read next, write next, reset (rewind). Non è permesso il rewrite in quanto si rischia inconsistenza se si scrive qualcosa a metà del file in quanto si potrebbe eliminare ciò che sta dopo.
Diretto
Come accade nel database in cui un file è una sequenza numerata di blocchi detti record. Le operazioni permesse sono read n, write n, position to n, read next, write next, rewrite n.
Struttura delle directory
Le directory sono una collezione di nodi contenenti informazioni sui file. Si trovano entrambi sul disco e determinano la struttura del file system. Per ogni file contengono il nome, tipo, indirizzo, lunghezza attuale, massima lunghezza, data di ultimo accesso, data di ultima modifica, proprietario e informazioni di protezione.
Operazioni sulla directory
- Aggiungere un file.
- Cancellare un file.
- Visualizzare il contenuto della directory.
- Rinominare un file.
- Cercare un file.
- Attraversare il file system.
Organizzazione logica
I vantaggi dell’organizzazione logica delle directory sono l’efficienza (rapido accesso ad un file), nomenclatura conveniente agli utenti in quanto permette stessi nomi per file e utenti diversi e nomi diversi per lo stesso file e raggruppamento: i file vengono classificati logicamente per un criterio come il tipo o la protezione.
Grazie alle directory il file system può assumere diverse strutture, definite durante l'implementazione. Vediamone alcune.
Directory a un livello
In questo metodo si trova una singola directory per tutti gli utenti. Nascono problemi di nomenclatura, in quanto è difficile ricordare se un nome esiste già e inventarne sempre di nuovi. Nascono inoltre problemi di raggruppamento.
Directory a due livelli
In questo metodo si trova una directory separata per ogni utente. Nasce il concetto di percorso (path), è possibile usare lo stesso nome di file per utenti diversi e la ricerca è efficiente. Non esiste comunque raggruppamento e si pone il problema di dove mettere i programmi di sistema condivisi dagli utenti (in Unix si usa PATH).
Directory ad albero
In questo metodo la directory viene implementata come un albero permettendo una ricerca efficiente e la possibilità di raggruppamento. Nasce il concetto di working directory e i nomi di percorso possono essere assoluti o relativi. Tuttavia manca ancora la possibilità di condivisione di file e directory.
Directory a grafo aciclico
In questo metodo si espande la versione ad albero a grafo aciclico per permettere la condivisione di file.
La condivisione avviene:
- in Windows: attraverso i collegamenti
- in Unix: attraverso i link, che in base alle policy sviluppate in merito possono essere di 2 tipi.
- link simbolici: un semplice file contenente un percorso ad un file/directory reale. Nel caso la risorsa venga eliminata si può scegliere se ricercare nel file system i vari link simbolici relativi ed eliminare anche essi oppure lasciarli pendenti. Corrispondono ai collegamenti in UNIX/Windows.
- hard link: non permettono l’eliminazione del file linkato se esistono ancora hard link che lo puntano. Viene tenuto per il file un contatore con il numero di riferimenti ad esso, il file può essere eliminato solo se tale contatore è a 0.
Directory a grafo generico
Questo metodo nasce come estensione della directory a grafo aciclico e si deve garantire che le ricerche terminino per evitare loop infiniti nell’attraversamento del grafo (visto che in questo caso può avere cicli). Per risolvere questo problema si può permettere di collegare solo file non directory o usare un algoritmo di controllo di esistenza di un ciclo ogni volta che si crea un nuovo collegamento, che può essere costoso.
Mount di un file system
Il mount di un file system è il processo attraverso il quale un file system viene aggiunto al sistema operativo e reso accessibile. Quando si crea un file system, è possibile renderlo modulare, consentendo di collegare (mount) e scollegare (unmount) interi file system a file system esistenti.
Prima di poter accedere a un file system però, è necessario montarlo. Il processo di montaggio richiede che un file system sia associato a un punto specifico del sistema operativo, noto come "mount point". Il mount point è una directory esistente nel sistema di file che funge da punto di accesso al file system che viene montato. Una volta montato, il file system diventa parte integrante del sistema operativo e può essere utilizzato per leggere o scrivere dati.
Condivisione di file
La condivisione di file è importante in sistemi multiutente ed è realizzabile tramite uno schema di protezione. Nei sistemi distribuiti, i file possono essere condivisi attraverso una rete. Per esempio, il Network File System (NFS) è un tipico schema di condivisione di file via rete.
Protezione
Il possessore di un file deve poter controllare cosa è possibile fare su un file e da parte di chi. Per farlo si può implementare una lista di accesso per ogni file o directory che lista chi può fare cosa.
Gli utenti si possono raggruppare in tre classi con una perdita di generalità: il proprietario, il gruppo (utenti appartenenti allo stesso gruppo del proprietario) e gli altri. Per ogni classe i permessi possono essere di read(r), write(w) ed execute(x).
CHMOD
In Unix per esempio, è possibile cambiare i permessi di un file utilizzando il comando chmod.
Un esempio di utilizzo può essere il seguente:
chmod 754 nome_file
dove le 3 cifre rappresentano rispettivamente il livello di permessi per l'utente, il livello di permessi del gruppo e il livello di permessi generale. In base alla cifra si ha una serie di permessi. La tabella seguente indica il significato dei singoli valori:
| Valore decimale | Permessi |
|---|---|
| 7 | lettura, scrittura ed esecuzione |
| 6 | lettura e scrittura |
| 5 | lettura ed esecuzione |
| 4 | solo lettura |
| 3 | scrittura ed esecuzione |
| 2 | solo scrittura |
| 1 | solo esecuzione |
| 0 | nessuno |
Dunque nel nostro esempio il proprietario ha i permessi di read, write ed execution, il gruppo non ha la write, e gli altri solo la read.
Implementazione di un file system
Per gestire un file system si usano diverse strutture dati in parte su disco e in parte in memoria. Le caratteristiche, pur avendo una base comune sono fortemente dipendenti dal sistema operativo e dal tipo di file system.
Strutture su disco
- Blocco di boot: contiene le informazioni necessarie per l’avvio del sistema operativo.
- Blocco di controllo delle partizioni: contiene i dettagli riguardanti la partizione come numero e dimensione dei blocchi, la lista dei blocchi liberi, dei descrittori liberi.
- Strutture di directory: descrivono l’organizzazione dei file.
- Descrittori dei file: contengono vari dettagli sui file e i puntatori ai blocchi dati.
Strutture in memoria
- Tabella delle partizioni: informazioni sulle partizioni montate.
- Strutture di directory: copia in memoria delle directory a cui si è fatto accesso di recente.
- Tabella globale dei file aperti con le copie dei descrittori dei file.
- Tabella dei file aperti per ogni processo contenente il puntatore alla tabella globale e le informazioni di accesso.
Allocazione dello spazio su disco
I blocchi su disco possono essere allocati in modi diversi con l’obiettivo di minimizzare i tempi di accesso e massimizzare l’utilizzo dello spazio.
Allocazione contigua
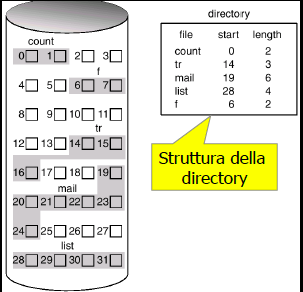
In questo metodo ogni file occupa un insieme di blocchi contigui su disco. L’entry della directory è semplice in quanto contiene l’indirizzo del blocco di partenza e la lunghezza del file.
Vantaggi
- Permette un accesso semplice in quanto l’accesso al blocco
non richiede lo spostamento della testina rispetto al blocco , a meno che non sia l’ultimo blocco di un cilindro (raro). - Supporta sia l’accesso sequenziale che casuale in quanto per leggere il blocco
di un file che inizia al blocco basta leggere .
Svantaggi
- Presenta problemi simili a quelli dell’allocazione dinamica della memoria: si deve scegliere tra algoritmi bestfit, first-fit o worst-fit e porta a uno spreco di spazio dovuto a frammentazione esterna e richiede una compattazione periodica dello spazio.
- La decisione della dimensione dello spazio da allocare è un problema, in quanto i file potrebbero crescere dinamicamente.
- Si può fare in modo che, se il file deve crescere e non c’è spazio, nasce un’errore e una terminazione del programma e si riesegue. In questo modo si tende a sovrastimare lo spazio necessario che porta a uno spreco.
- Un’altra soluzione consiste nel trovare un buco più grande e ricopiare tutto il file in questo, operazione trasparente per l’utente ma che rallenta il sistema.
Variante
Alcuni file system moderni usano uno schema modificato di allocazione contigua come Linux ext2fs basato sull’extent, una serie di blocchi contigui su disco. Il file system alloca extent invece di blocchi singoli che in generale non sono contigui e si prestano pertanto per l’allocazione a lista.
Allocazione a lista
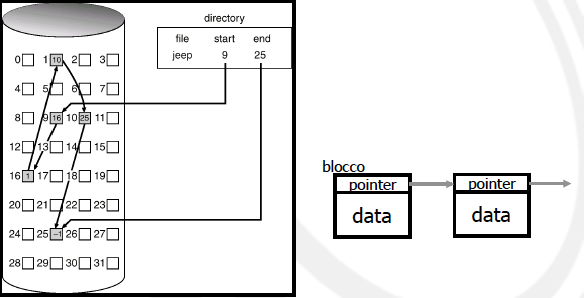
In questo metodo ogni file è costituito da una lista di blocchi concatenati, che possono essere sparsi ovunque nel disco.
La directory contiene puntatori al primo e all’ultimo blocco e ogni blocco contiene un puntatore al blocco successivo. Considerando
del blocco nella lista, mentre
Vantaggi
- L’allocazione a lista permette una semplice creazione di un nuovo file in quanto basta cercare un blocco libero e creare una nuova entry nella directory che punta ad esso.
- Anche l’estensione del file è semplice: si cerca un blocco libero e lo si concatena alla fine del file. Non c’è spreco se non si considera lo spazio per il puntatore in quanto si può usare qualunque blocco e non c’è frammentazione esterna.
Svantaggi
- Non permette però accesso casuale in quanto bisogna scorrere tutti i blocchi a partire dal primo.
- Richiede tanti riposizionamenti sparsi che portano a scarsa efficienza.
- È inoltre scarsamente affidabile in quanto la perdita di un puntatore o un errore causa il prelevamento del puntatore sbagliato. Si devono quindi introdurre metodi di recupero con overhead come le liste doppiamente concatenate e memorizzare il nome del file e il numero di blocco in ogni blocco del file.
Variante - FAT (file allocation table)
Una variante che migliora l'accesso casuale fa uso della File Allocation Table (FAT). Questa è una tabella che occupa i primi blocchi del volume e contiene una lista di tutti i blocchi allocati. Inoltre, per ogni blocco si registra anche la posizione del suo blocco successivo. Purtroppo le dimensioni della FAT (spesso FAT32 perchè con entry di 32 bit) impediscono una scansione efficiente e cominciano ad occupare una porzione significativa di memoria con l'aumentare delle dimensioni del disco. Questi svantaggi rendono oggi l'uso della FAT proibitivo.
L’accesso diretto ai file di grandi dimensioni, per esempio utilizzando la system call lseek, può essere inefficiente nei file system di tipo FAT a causa del modo in cui i dati vengono organizzati e gestiti. In un file system FAT, i dati vengono memorizzati in cluster di dimensioni fisse. Quando si accede a un file, il sistema operativo deve seguire una catena di cluster per trovare il cluster corretto che contiene i dati richiesti. Per i file di grandi dimensioni, questo può comportare il passaggio attraverso molti cluster, il che può richiedere molto tempo. Inoltre, se il file è frammentato (cioè i suoi cluster non sono contigui), il tempo necessario per trovare il cluster corretto può aumentare ulteriormente. Questo può rendere l’accesso diretto ai file di grandi dimensioni utilizzando lseek inefficiente nei file system di tipo FAT.
Allocazione indicizzata
In questo metodo ogni file ha un blocco indice (index block) che contiene la tabella degli indirizzi dei blocchi fisici, ossia il blocco indice punta a tutti gli altri blocchi dello stesso file. La directory contiene l’indirizzo del blocco indice. Se
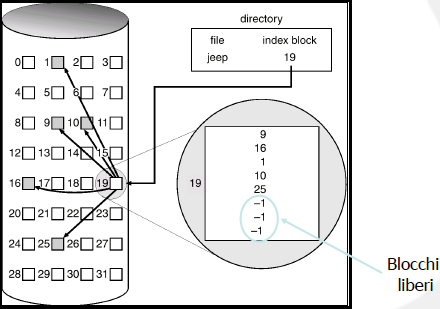
Vantaggi
- L’accesso casuale è efficiente.
- Non c'è frammentazione esterna.
Svantaggi
- Rispetto all'allocazione a lista (non alla FAT) tende a sprecare più memoria, in quanto per ogni file richiede l'allocazione di un blocco indice che potrebbe essere non del tutto utilizzato.
- La dimensione del blocco indice limita la dimensione del file massima. Infatti, se per esempio il blocco indice ha 512 entry (gli indirizzi fisici), e ogni indirizzo fisico corrisponde ad un blocco di 512 parole, la dimensione del file può essere massimo di
parole. Pertanto, per i file di grandi dimensioni, si usano schemi a più livelli, che vedremo ora.
Indici multilivello
Il blocco indice punta ad altri blocchi indici, che punteranno ai dati dei file veri e propri.
Sia
Per esempio, blocchi da 4KB consentono 1K indici da 4 byte, mentre due livelli di indici consentono file da 4GB.
Schema concatenato
Si usano più blocchi indice collegati tramite una lista concatenata: l’ultimo degli indici di un blocco indice punta a un altro blocco indice.
Esempio
N = 1KB = 256 parole (parola=32bit)
- 4 byte per parola
Max file = 256 blocchi da 1KB = 256KB
(blocco 47) (parola 168 all’interno del blocco 47)
Non basta un primo livello (blocco della lista concatenata) (offset nel blocco index) (offset nel blocco dati)
Schema combinato
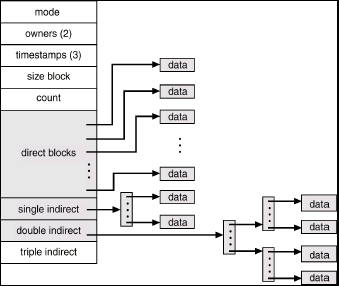
Unix usa lo schema combinato in cui ad ogni file è associato un i-node (index-node) che contiene gli attributi del file e fa da blocco indice. Gli i-node sono gestiti dal sistema operativo e memorizzati in modo permanente in una porzione riservata al sistema operativo di solito all’inizio del disco. Per memorizzare i blocchi di dati del file, ogni i-node contiene:
- 10 puntatori diretti ai blocchi di dati di file.
- Un puntatore single indirect che punta ad un blocco indice che contiene puntatori a blocchi di dati di file.
- Un puntatore double indirect che punta ad un blocco indice che contiene puntatori a blocchi indice contenenti puntatori a blocchi di dati di file.
- Un puntatore triple indirect che punta ad un blocco indice che contiene puntatori a blocchi indice che contengono puntatori a blocchi indice che contengono puntatori a blocchi di dati di file.
Implementazione delle directory
Le directory vengono implementate con lo stesso meccanismo usato per memorizzare i file. Non contengono dati, ma una lista di file e directory. Questo spazio può essere memorizzato in due modi:
- lista di puntatori ai blocchi dati: la directory contiene una lista di puntatori al primo blocco di ogni file. È di facile implementazione ma poco efficiente in quanto lettura, scrittura e rimozione di file richiedono una ricerca per trovare il file.
- tabella hash: con tempo di ricerca migliore ma che richiede la gestione delle collisioni.
Gestione dello spazio libero
Per tenere traccia dello spazio libero su disco si mantiene una mappa dei blocchi liberi. Per creare un file si cercano blocchi liberi nella mappa e per rimuovere un file si aggiungono i suoi blocchi a tale mappa. Vediamo ora diverse alternative per implementare la mappa.
Vettore di bit
Si mantiene un vettore in cui ogni posizione indica se un blocco è occupato o no.
Lista concatenata di blocchi liberi (free list)
Ogni blocco libero punta ad un altro blocco libero. Permette spreco minimo(solo per la testa della lista) ma lo spazio contiguo non è ottenibile.
Raggruppamento
Il concetto è simile a quello della lista concatenata, ma qui un blocco contiene la lista di
Conteggio
Si usa una lista che contiene ad ogni entry un blocco libero e quanti blocchi liberi consecutivi seguono.
La lista risulta più corta se il contatore è maggiore di 1 per ogni gruppo di blocchi liberi.
Efficienza e prestazioni
Efficienza
Il disco è un collo di bottiglia e l’efficienza dipende dall'algoritmo di allocazione dello spazio su disco e dal tipo di dati contenuti nella directory.
Prestazioni
Il controller del disco possiede una piccola cache che è in grado di contenere un’intera traccia ma non basta per garantire prestazioni elevate, pertanto si usano dischi virtuali (RAM disk) e cache del disco o buffer cache.
Dischi virtuali
Parte della memoria viene gestita come se fosse un disco: il driver di un RAM disk accetta tutte le operazioni standard dei dischi eseguendole in memoria. È veloce ma supporta solo file temporanei. Viene gestito dall’utente che scrive sul RAM disk invece che sul disco.
Cache del disco
È una porzione di memoria che memorizza blocchi usati di frequente, simile alla cache tra memoria e CPU.
Viene gestita dal sistema operativo e sfrutta il principio di località spaziale e temporale. Il trasferimento di dati nella memoria del processo utente non richiede spostamento di byte. Nascono problematiche riguardanti la politica di rimpiazzamento del blocco (se la cache è piena devo scegliere il blocco da togliere usando LRU, LFU, RANDOM, ecc.) e la politica di scrittura. Cioè se devo scrivere sul blocco usato di recente, intanto scrivo su quello in cache ma quando aggiorno quello originale che è memorizzato su disco?
Posso decidere di fare write-back, ovvero scrivere solo quando devo rimuovere il blocco dalla cache (può generare problemi di affidabilità in caso di crash) oppure write-through, scrivendo sempre (meno efficiente, la cache è praticamente in sola lettura).
Recupero
I problemi di consistenza tra disco e cache possono essere risolti attraverso un controllo di consistenza che confronta i dati nella directory con i dati su disco e sistema le inconsistenze, oppure attraverso l’uso di programmi di sistema per fare il backup del disco su memoria di massa come i nastri che permettono il recupero di file persi tramite il restore dei dati di backup.
File system log structured
Si registra ogni cambiamento del file system come una transazione. Tutte le transazioni sono scritte su log e considerate completate quando vengono scritte su log (anche se il file system può non essere aggiornato). Le transazioni sono scritte in modo asincrono nel file system e quando il file system è modificato la transazione viene cancellata dal log. Se il sistema va in crash le transazioni non avvenute sono quelle presenti sul log.
In questo modo si ottimizza il numero di seek.